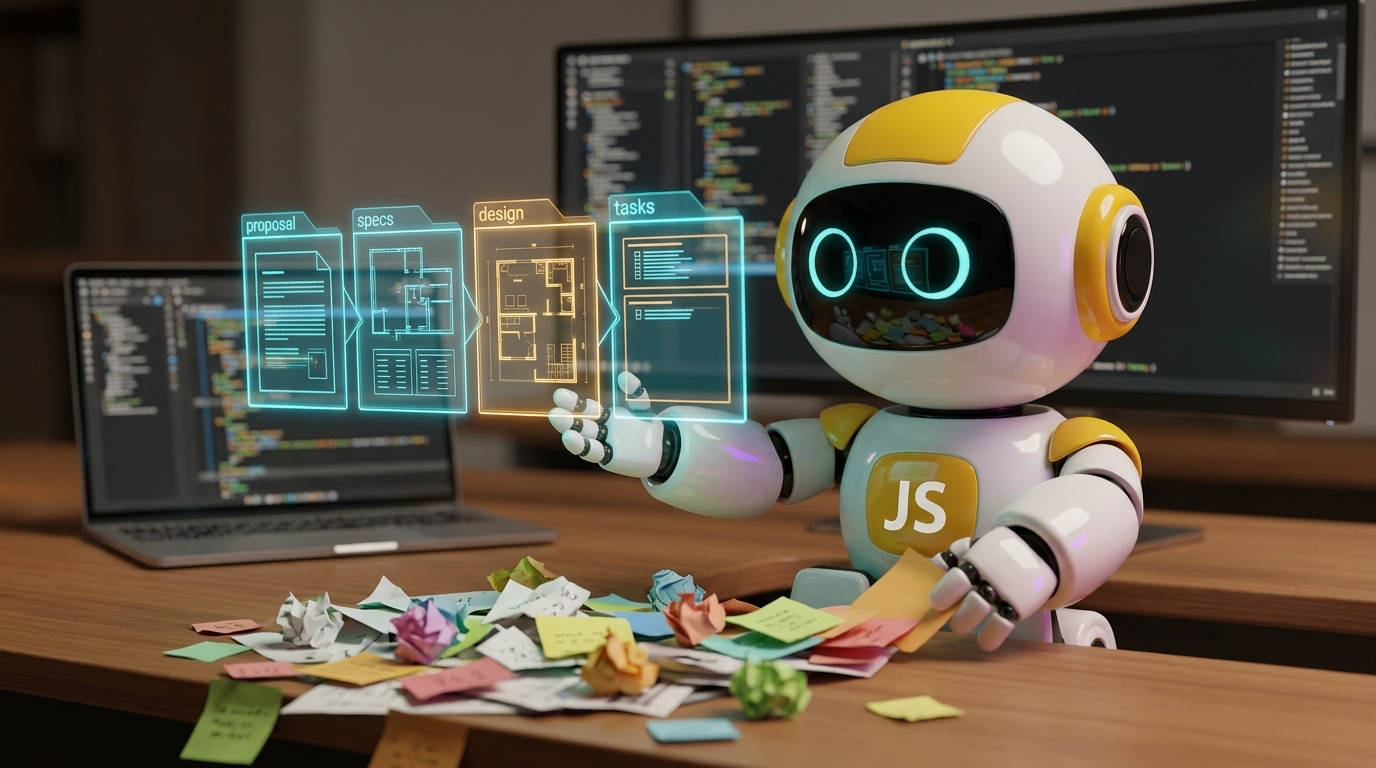
La tarde del viernes en que el vibe coding se nos fue de las manos
Imagina la escena. Es viernes a las cuatro de la tarde y estás construyendo PayFlow, una plataforma de pagos y gestión de pedidos en TypeScript. Solo te falta una pieza para cerrar el sprint, proteger los endpoints de cobros con autenticación JWT. Abres tu asistente de código en la terminal, llámese Claude Code, Codex u OpenCode, y le lanzas una instrucción rápida y confiada.
"Añade un sistema de autenticación con JWT a PayFlow y actualiza los endpoints de usuarios y pagos."
Durante los primeros dos minutos todo parece magia. El agente lee un par de archivos, empieza a escupir código a toda velocidad, crea middlewares, toca seis ficheros distintos y, cuando termina, te saluda con un entusiasta "¡Listo! Autenticación implementada."
Pero entonces abres el git diff y empieza el sudor frío.
- Decisiones que nadie aprobó. El modelo ha decidido por su cuenta guardar los tokens de refresco en memoria local en lugar de usar la base de datos del proyecto, y ha inventado un formato de error HTTP que no coincide con el resto de tu API.
- Amnesia entre sesiones. Si cierras la terminal o la ventana de contexto se compacta, nadie en el equipo, ni siquiera el propio agente mañana por la mañana, recordará por qué eligió esa librería de firmado o qué casos límite dejó fuera.
- Roturas silenciosas. El asistente jura que todo funciona, pero ha introducido una dependencia circular entre el módulo de usuarios y el de pagos, y ha modificado rutas públicas sin escribir ni una sola prueba que lo respalde.
En mis artículos anteriores sobre LangChain y LangGraph ya vimos este mismo problema desde el lado del runtime. Reemplazar el viejo AgentExecutor por grafos explícitos nació de la necesidad de sacar el razonamiento de una caja negra impredecible. Cuando usamos la IA para escribir nuestro propio software, el problema es idéntico, pero con consecuencias más caras. A esa práctica de lanzar un deseo en prosa libre y cruzar los dedos la llamamos "Prompt-and-Pray" (o vibe coding).
Y aquí viene la verdad incómoda. Cambiar a un modelo más caro o más nuevo no resuelve el problema. Un modelo de lenguaje no falla porque sea "tonto", sino porque le pedimos que improvise arquitectura, requisitos de negocio y código de producción al mismo tiempo en un chat efímero. La solución no está dentro del modelo, sino en lo que construimos a su alrededor, el arnés (harness) y los contratos previos.
En esta primera entrega de la serie inauguramos el viaje por Spec-Driven Development (SDD) con OpenSpec, construyendo paso a paso las bases sobre nuestro proyecto PayFlow. En esta entrega veremos cuatro pilares.
- Qué es realmente el harness engineering. Por qué separar el motor (el LLM) del chasis que lo gobierna cambia por completo la fiabilidad del desarrollo asistido por IA.
- Los cuatro artefactos antes del código. Cómo OpenSpec obliga a pactar el porqué, el qué, el cómo y el plan en disco antes de tocar
src/. - Anatomía de un repositorio OpenSpec. Cómo se organizan las especificaciones maestras, los cambios aislados y el historial auditable.
- La tríada humano, agente y CLI. Cómo un contrato
--jsonestricto evita que el asistente alucine sobre el estado del proyecto.
El modelo mental, el motor y el arnés (harness)
Para entender por qué necesitamos OpenSpec, piensa en un coche de Fórmula 1. El modelo de lenguaje (Claude, GPT, Gemini) es el motor. Tiene una potencia descomunal y puede generar cientos de líneas por minuto, pero por sí solo no sabe dónde está la pista ni cuándo frenar antes de una curva. Si sueltas un motor de 1.000 caballos sin chasis, dirección ni frenos, te estrellas en la primera esquina.
En ingeniería con IA, ese chasis, esa dirección y esos frenos son el arnés (harness), el conjunto de archivos estructurados, reglas deterministas y herramientas de verificación que rodean al modelo para encauzar su potencia.
Qué está pasando en este diagrama
Observa la diferencia estructural entre ambos caminos.
- En el enfoque tradicional (Prompt-and-Pray). No existe ningún punto de control entre tu frase en el chat y los archivos de producción en
src/. Cuando detectas que el modelo asumió mal una regla de negocio de PayFlow, ya tienes 400 líneas mezcladas en seis archivos y te cuesta más depurarlas que haberlas escrito tú desde cero. - En el paradigma OpenSpec SDD. Se introduce una aduana declarativa antes de escribir código. Con un comando como
/opsx:propose, el agente no tocasrc/, sino que redacta cuatro documentos en Markdown versionados dentro del repositorio. Tú los revisas con un simplegit diffen menos de dos minutos. Si algo no cuadra, se corrige en el plano antes de levantar los muros.
Para que ese plano no sea un ensayo literario ambiguo, OpenSpec exige articular exactamente cuatro dimensiones.
- El porqué (
proposal.md). El problema de negocio y los límites del cambio. En PayFlow, aquí dejamos claro que queremos proteger las rutas de pago con JWT, y explicitamos qué queda fuera (por ejemplo, que el login social con Google no entra todavía). - El qué (
specs/). El contrato funcional observable. No dice qué librería usar, sino qué debe pasar cuando un usuario envía un token caducado o sin cabecera, redactado con escenarios estructuradosWHEN / THEN. - El cómo (
design.md). La arquitectura técnica elegida. Aquí decidimos si usamosjoseojsonwebtoken, cómo modelamos los tipos en TypeScript y qué secuencia de llamadas sigue cada petición. - El plan (
tasks.md). Un checklist de subtareas atómicas y verificables. Es la hoja de ruta que el agente irá marcando de[ ]a[x]conforme implemente y pruebe cada pieza.
Anatomía de un repositorio OpenSpec
Una de las mayores preocupaciones cuando un equipo evalúa una herramienta nueva es cuánto invade su proyecto actual. La respuesta con OpenSpec es directa, cero invasión en tu código fuente. No tienes que importar ninguna librería en package.json ni cambiar cómo compilas TypeScript, Go o Python. Todo el arnés vive aislado en la carpeta openspec/ en la raíz de tu repositorio.
payflow-api/
├── openspec/
│   ├── config.yaml          # Constitución del proyecto (stack, arquitectura, reglas)
│   ├── changes/             # Cambios activos en vuelo (aislados del código maestro)
│   │   ├── add-jwt-auth/
│   │   │   ├── .openspec.yaml  # Metadatos del cambio (esquema activo y flags)
│   │   │   ├── proposal.md     # Motivación, alcance e impacto
│   │   │   ├── design.md       # Decisiones técnicas y diagramas
│   │   │   ├── tasks.md        # Lista de tareas atómicas [-] rastreadas por el CLI
│   │   │   └── specs/          # Especificaciones delta de este cambio
│   │   │       └── auth/
│   │   │           └── spec.md
│   │   └── archive/         # Historial inmutable de cambios cerrados (YYYY-MM-DD-*)
│   ├── specs/               # Especificaciones maestras (fuente de verdad viva del sistema)
│   │   └── auth/
│   │       └── spec.md
│   └── schemas/             # (Opcional) Flujos de trabajo personalizados
├── .agent/skills/           # Habilidades inyectadas para Antigravity / Claude / Cursor
└── src/                     # Tu código de aplicación (intacto hasta /opsx:apply)
Desgranando cada carpeta clave
openspec/config.yaml(la constitución). Es el archivo donde fijas las reglas inmutables del proyecto. Por ejemplo, que PayFlow usa TypeScript estricto, Vitest para tests y Clean Architecture. Cada vez que el agente vaya a planificar o programar, OpenSpec le inyectará estas directrices automáticamente.openspec/changes/(el taller de trabajo). Cada iniciativa vive en su propia subcarpeta (add-jwt-auth/). Mientras estás diseñando o programando, las especificaciones maestras del sistema no se ensucian con borradores a medio hacer.openspec/specs/(la fuente de verdad viva). Representa lo que PayFlow hace hoy en producción. Es el mapa canónico que tanto un ingeniero recién llegado como un agente de IA pueden leer para entender el sistema sin tener que hacer ingeniería inversa sobre miles de líneas de código.openspec/changes/archive/(la caja negra histórica). Cuando terminas un cambio, su carpeta se mueve aquí con fecha (2026-11-12-add-jwt-auth). Si dentro de ocho meses alguien se pregunta por qué la expiración de los tokens se fijó en 15 minutos, la respuesta y el contexto siguen intactos en el repositorio.
La tríada de ejecución, humano, agente y CLI
Mucha gente piensa que OpenSpec es un conjunto de prompts bonitos en Markdown. Si fuera solo eso, el agente seguiría cometiendo errores, olvidaría qué archivo va primero, crearía carpetas con nombres inventados o marcaría tareas terminadas sin haber comprobado nada.
Por eso OpenSpec funciona como una tríada donde cada actor tiene un papel muy claro. Tú decides la intención y apruebas el plan, el agente razona y escribe, y la CLI de OpenSpec actúa como el árbitro determinista que valida el estado real en disco.
Qué ocurre bajo el capó paso a paso
Fíjate en los pasos 2 al 5 del diagrama. Cuando tú escribes /opsx:propose en tu asistente.
- El agente no crea carpetas a mano. Invoca
openspec new change add-jwt-auth. Así nos aseguramos de que el directorio nace con su archivo.openspec.yamlválido y en la ruta correcta. - El agente pide instrucciones a la CLI. Ejecuta
openspec instructions proposal --change add-jwt-auth --json. La CLI leeconfig.yaml, carga la plantilla oficial deproposal.mdy le devuelve al modelo un paquete exacto con lo que debe redactar y las restricciones que debe respetar. - Separación estricta entre modo humano y modo máquina (
--json). Este detalle es oro puro en harness engineering. Cuando tú ejecutas un comando en la terminal, quieres tablas bonitas, colores y spinners de carga. Pero si un agente intenta leer esa salida decorada, los códigos de color ANSI o un texto inesperado pueden romper su análisis. Por contrato (agent-contract), al pasar--json, OpenSpec emite exclusivamente un documento JSON válido porstdouty envía cualquier aviso o progreso auxiliar astderr. El modelo nunca tiene que "adivinar" si algo falló, lee"valid": trueo"valid": falsey actúa en consecuencia.
Dos velocidades de trabajo, perfil core vs. expanded
No todos los cambios en PayFlow tienen el mismo nivel de riesgo. Añadir un botón en el panel interno no requiere la misma ceremonia que rediseñar la pasarela de cobros. Por eso, al inicializar OpenSpec, puedes elegir entre dos perfiles operativos.
- Perfil
core(ágil por defecto). Pensado para el 80% de tu día a día. Concentra todo el flujo en tres comandos esenciales,/opsx:propose(genera toda la planificación de golpe),/opsx:apply(implementa el checklist) y/opsx:archive(consolida las especificaciones enopenspec/specs/y archiva el cambio). - Perfil
expanded(control granular). Pensado para cambios arquitectónicos delicados o equipos con revisiones estrictas. Desdobla la planificación en pasos individuales (/opsx:newpara crear solo el cascarón,/opsx:continuepara avanzar artefacto por artefacto revisando cada uno) e incorpora/opsx:verifypara auditar formalmente el código contra los escenarios antes de archivar.
Lo interesante es que ambos perfiles trabajan sobre los mismos archivos en disco. Puedes empezar un cambio con el flujo ágil y, si la complejidad crece, pasar a auditarlo paso a paso sin migrar nada.
Laboratorio práctico, tu primer arnés en PayFlow
Vamos a llevar la teoría a la terminal para comprobar cómo se inicializa OpenSpec en un proyecto real y qué ve exactamente el agente cuando inspecciona el repositorio.
Paso 1. Comprobar la CLI e inicializar el entorno
Abre una terminal en la raíz de tu proyecto de pruebas (imaginemos que es el repositorio payflow-api) y verifica que tienes la herramienta instalada antes de inicializar el arnés para tu asistente.
# 1. Confirmar que la CLI de OpenSpec responde correctamente
openspec --version

# 2. Inicializar OpenSpec e instalar las skills para tu asistente (ej. claude, cursor, antigravity)
openspec init --tools claude
Qué acaba de ocurrir en tu disco. El comando openspec init no ha tocado ni un solo archivo dentro de src/. Lo que ha hecho es crear la carpeta openspec/ con sus subdirectorios vacíos (changes/, specs/), generar un openspec/config.yaml base comentado y copiar las definiciones de los comandos /opsx:* dentro de la configuración de tu asistente para que sepa interactuar con la CLI.
Paso 2. Consultar el estado del proyecto como lo hace el agente
Ahora ejecuta el validador en modo máquina para ver exactamente la respuesta que recibe tu asistente de IA antes de empezar a trabajar.
openspec validate --jsonLa terminal imprimirá un bloque JSON limpio y predecible como este.
{
  "items": [
    {
      "id": "init-check",
      "type": "project",
      "valid": true,
      "issues": []
    }
  ],
  "summary": {
    "totals": { "items": 1, "passed": 1, "failed": 0 }
  },
  "version": "1.0"
}
Fíjate en la potencia de esta salida. No hay prosa ambigua ni conjeturas. El bloque summary.totals le entrega al agente un veredicto binario ("failed": 0) y una lista issues donde, si algún archivo tuviera un error de formato, aparecería el diagnóstico exacto para corregirlo antes de seguir adelante.
Autoevaluación
Pon a prueba lo que acabas de aprender antes de avanzar al siguiente capítulo.
- ¿En qué se diferencia fundamentalmente el Spec-Driven Development (SDD) del prompt engineering tradicional? El prompt engineering optimiza un mensaje puntual en una sesión de chat efímera que se pierde al cerrar la ventana. Spec-Driven Development construye un arnés de ingeniería duradero en el repositorio mediante cuatro artefactos versionados (
proposal,specs,design,tasks) que humano y agente acuerdan y revisan mediantegit diffantes de escribir una sola línea de código en producción. - ¿Por qué OpenSpec separa
openspec/specs/deopenspec/changes/? Porqueopenspec/specs/es la fuente de verdad viva de lo que el sistema hace hoy en producción, mientras queopenspec/changes/<id>/actúa como un taller aislado para cada cambio en curso. Así puedes planificar e iterar funcionalidades nuevas sin contaminar ni corromper la documentación maestra hasta que el trabajo esté validado. - ¿Por qué el contrato
--jsonde la CLI separa estrictamentestdoutdestderr? Porque los agentes de IA consumen la salida estándar (stdout) mediante parsers estructurados. Si la CLI imprimiera spinners, barras de progreso o mensajes decorativos enstdout, rompería el JSON y obligaría al modelo a adivinar el estado del repositorio. Canalizando todo el ruido humano astderr,stdoutqueda reservado para un único JSON determinista.
En el próximo artículo...
Ya tenemos el arnés montado en PayFlow y sabemos por qué necesitamos pactar contratos antes de programar. Pero aquí suele saltar la alarma de cualquier ingeniero con experiencia, "¿Tener que definir propuesta, especificaciones, diseño y tareas antes de programar no es volver a la burocracia rígida del modelo en cascada (Waterfall)?"
En la segunda entrega desmontaremos ese mito explorando La anatomía de un cambio y el grafo DAG de artefactos. Veremos cómo OpenSpec modela las dependencias como habilitadores y no como puertas cerradas, y aprenderemos la gramática exacta con la que debemos redactar requisitos para que un LLM nunca malinterprete un caso de negocio.